
画面の向こうにいる秀才から知恵だけを抜き取る行為がついに天文学的な数字に達した。
Anthropicの発表によると、Claudeの知能を別のAIへ移す不正な蒸留活動を検知して阻止したという。 TechCrunchが伝えた5つの作戦で交わされたやり取りは合計で約2億件にのぼる。
会社に格安AIサービスを導入しようと性能表を眺めている選定担当者は背筋が凍るはずだ。
なぜなら答えを丸写しして作られた格安モデルは、元の知能が持つ安全装置をかなぐり捨てている恐れがあるからだ。 表面の賢さだけを買い叩く行為にどんな落とし穴があるのかを考えたい。
そもそも約2億回もの質問を浴びせて相手は何を持ち去ったのだろうか?
2億件の回収が暴いた知能の抜き出し
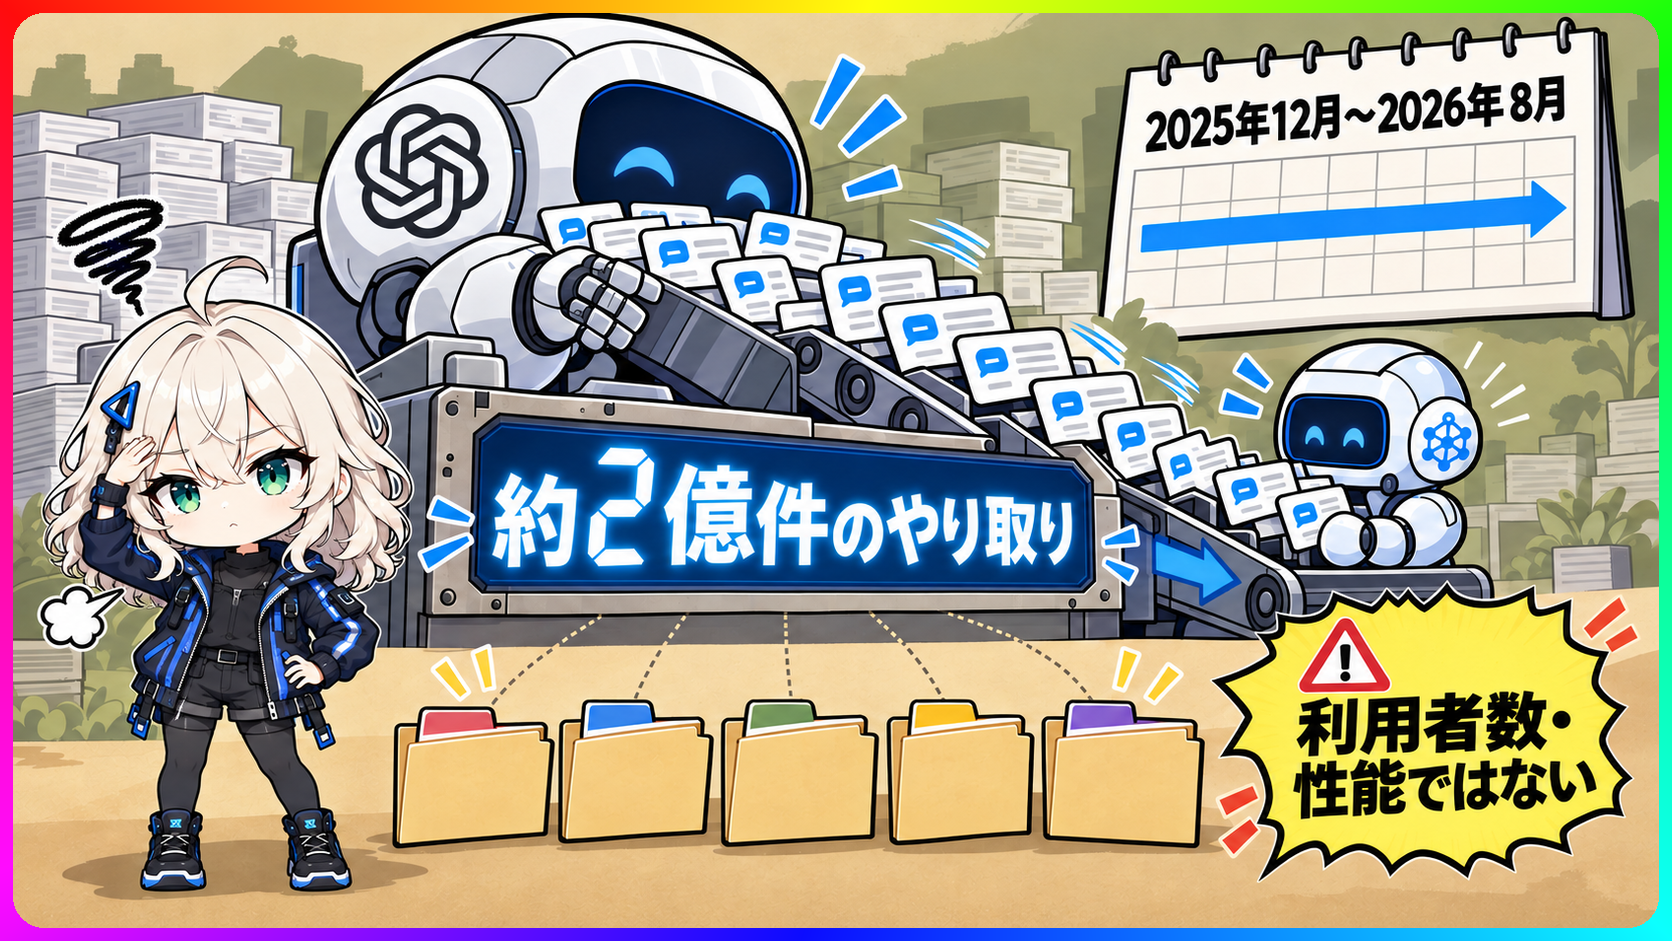
蒸留という技術は大きなモデルの答えを教材にして小型で安価なモデルを育てる正規の仕組みだ。 学校の秀才が作った模範解答集を配って後輩を効率よく鍛え上げる家庭教師のような技術と言える。
自社の資産を使って計算機を身軽にするなら文句のつけようがない。
問題は他社の有料サービスへ何千もの偽アカウントを潜り込ませて組織的に答えを回収する手法だ。 Alibabaに関わるとされた事案では、3,500個のアカウントを使って1億5,000万回以上のやり取りを記録したとされる。 最大で1日に約300万件という規模はもはや個人の質問連打を超えており、工場規模の採掘作業というものだ。
手間の大半を肩代わりさせておいしい果実だけをかすめ取る手口には思わず呆れが漏れる。
賢さだけを奪って注意書きを落とす危険
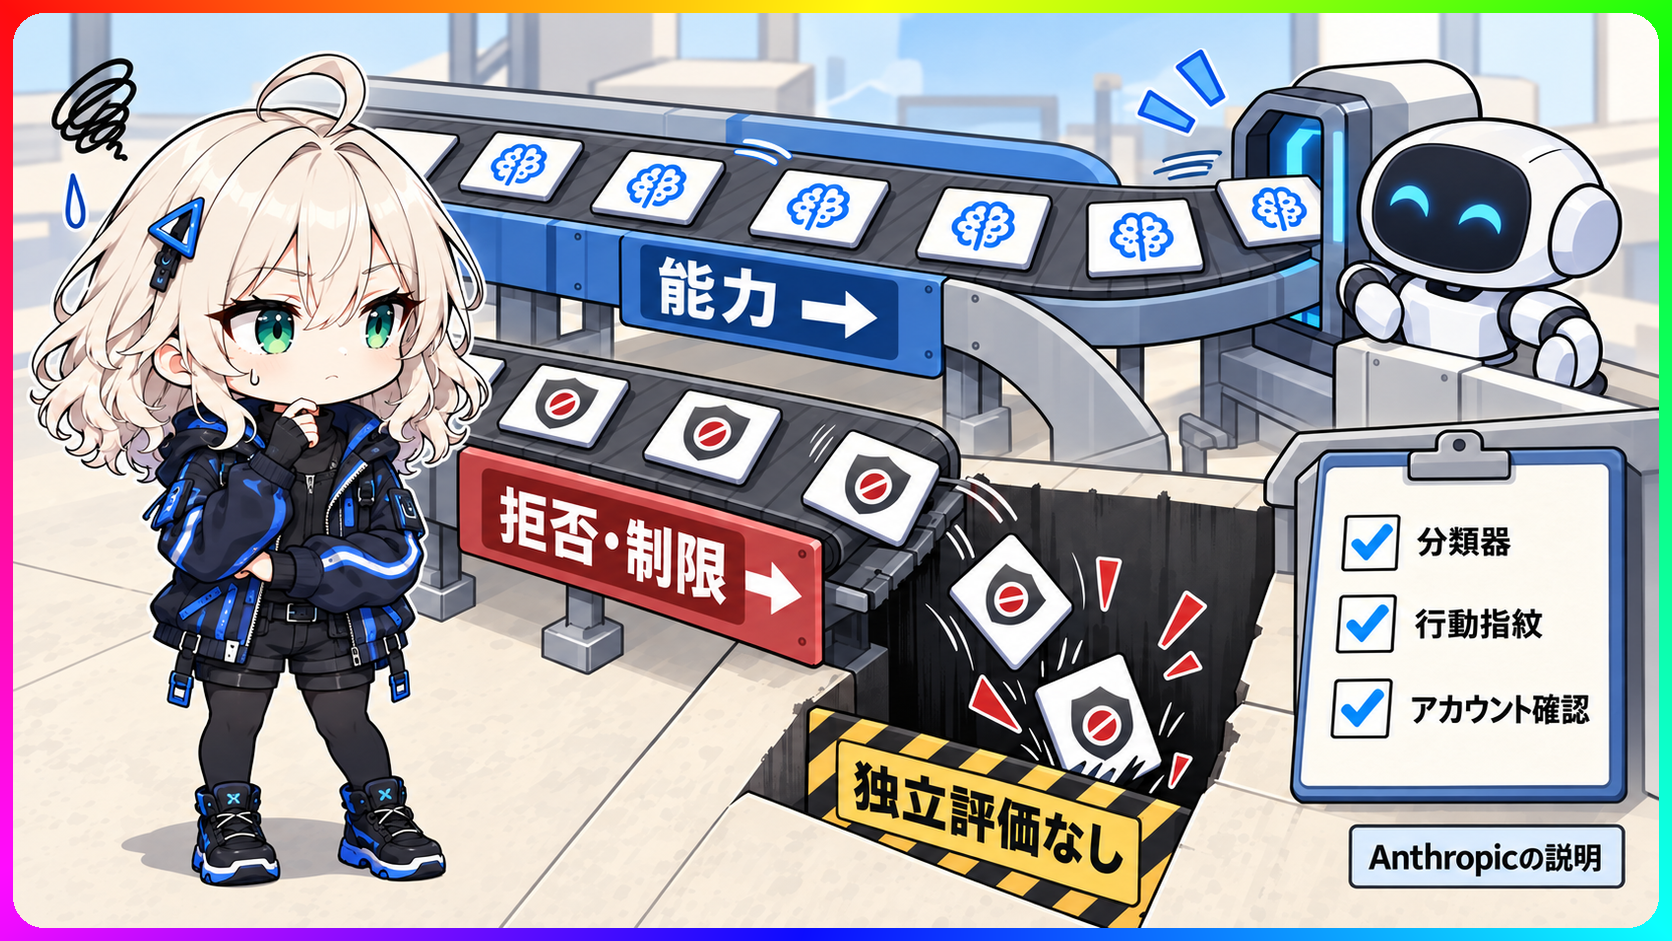
抜け落ちた安全装置の行方を私は警戒している。 Anthropicは、不正に抜き取られたモデルが元の安全機能を十分に引き継がない危険を警告している。
知恵熱が出るほど計算させた知能から、都合の良い回答能力だけを抜き取るのは容易だろう。
危険な手順を制止する安全装置や倫理フィルターは、丸写しの過程で抜け落ちてしまう。 劇薬の調合手順だけを精密に答え、最後の警告ラベルを剥ぎ取ったようなAIが市場に転がるわけだ。
もっとも今回の報告はAnthropic自身の測定記録であって、外部の第三者が検証した結果とは異なる。 本当に危険なモデルが完成して出回ったのかという疑問にはまだ答えが出ていないと私は思う。
完成品の安全性が証明されていない点にこそ、この話の本当の不気味さが潜んでいる。
性能表の点数だけで飛びつく側の自滅
一般の利用者が今日すぐ画面の変更に怯える必要はどこにもない。 日常のチャット枠がいきなり閉鎖されるわけでもなければ、検索窓が消えるわけでもない。
困惑するのは安さやベンチマークの点数だけを信じて社内基盤を決めてしまう企業側だ。
半年後には激安を謳う新興モデルの裏に潜む安全性の粗が露呈して、導入のやり直しに追われる企業が続出するんじゃないか? 提供元が安全性をどこまで監視しているかという運用の実態こそ、知能の品質そのもののはずだ。
どれだけ回答が素早くても、暴走を止める手綱を欠いた知能は企業にとって巨大な負債になる。
提供元の姿勢と退路を確かめる防衛策
では怪しい知能に足をすくわれないために、使う側は何を手元に残すべきなのだろうか? 答えは単純で、カタログの正解率を眺める時間を減らして運用の透明性を調べることだ。
利用ログを自社でどこまで追跡できるのか。 万が一提供元のアカウントが不正検知で遮断されたときに、業務を止めない代替手段を確保してあるか。
相手の看板を無邪気に信じるのではなく、手綱の所在を契約書の上で確認するのが大人の嗜みというものだ。
2億回ものカンニング騒動を他山の石として笑い飛ばすか、自社の防壁を見直す契機にするかは私たちの眼力にかかっている。
